Mostrando entradas con la etiqueta http. Mostrar todas las entradas

lunes, 3 de octubre de 2016

Fingerprinting II - Métodos HTTP

Buenas compañeros,

Esta es la segunda entrada de la serie de Fingerprinting, que habíamos dejado pausada tras la anécdota del chihuahua.

El objetivo de esta prueba, que viene marcada en OWASP, consiste en averiguar los métodos HTTP permitidos por el servidor web para comprobar si se encuentra habilitado alguno que no debería y de esta manera aprovecharlos para comprometer el sitio web.

Entre los métodos HTTP se tienen:

GET: El método más común en la navegación web. Devuelve un código de respuesta y las cabeceras asociadas. Incluye el documento solicitado (habitualmente una página) en el cuerpo del mensaje.

HEAD: Idéntico al anterior, con la salvedad de que no devuelve el documento en el cuerpo de la respuesta. Se utiliza para extraer información sobre el documento solicitado o comprobar si existe sin necesidad de enviar y recibir el documento como tal. A veces sirve para bypass controles que requieren de login si se encuentran mal configurados.

POST: Pensado para publicar la información contenida en el cuerpo de la petición en el recurso donde se envía esa petición. La información que se publica y la forma de hacerlo depende completamente del servidor y el recurso. Hoy, el uso que se le da a este método es el de paso de parámetros de cliente a servidor (en muchas ocasiones para ficheros). La respuesta por parte del servidor es la misma que para una petición GET. Es recomendable emplear este método en el envío de formularios que puedan contener información sensible para evitar que aparezcan en logs.

TRACE: Implementa la función de eco para los mensajes HTTP. El servidor responde en el cuerpo del mensaje con la misma petición que el cliente ha realizado. Se utiliza para comprobar que las peticiones son recibidas correctamente. Su finalidad es la de depuración.

OPTIONS: Este método presenta las opciones que el recurso o servidor dispone o requiere. De esto se puede obtener información como por ejemplo los métodos permitidos (en la cabecera ALLOW).

CONNECT: Utilizado para crear la comunicación con un proxy HTTP (SSL).

PUT: Mediante este método es posible almacenar el documento que se envía como cuerpo de la petición en el propio servidor (físicamente en disco). Si el recurso al que se hace referencia en la petición no existe se creará y si existe se sobrescribirá, es decir, para subir ficheros.

DELETE: Al igual que el método PUT, este verbo afecta directamente al recurso al que se hace la petición. Tiene la capacidad de eliminar el elemento y dejar al servidor sin ese recurso.

Tras ver la teoría vamos a la práctica! Para estas prácticas se puede emplear el terminal de Linux con netcat pero este caso vamos a emplear Burpsuite:

OPTIONS

Devuelve información del servidor respecto a los métodos permitidos.


La imagen anterior muestra una correcta configuración, mientras que en la siguiente no sería así:


No fiarse de esta información pues no es ni completa ni veraz. En ocasiones indica que se permite pero luego no está implementado el método.

Y en otras ocasiones ocurrirá lo contrario, la cabecera ALLOW de la petición OPTIONS no mostrará métodos que realmente están permitidos e implementados... aunque luego es posible su ejecución. En resumen, no se deben descartar los métodos que no estén reflejados en esa cabecera.

Es buena práctica comprobar la respuesta del servidor ante cabeceras inexistentes:

Los método más peligrosos son PUT y DELETE pero también destaca TRACE que posibilita posible robo de cookies.


TRACE

En este método se podría incluir un parámetro asociado a un valor, por ejemplo, una cookie de tal manera que, este método devuelve como cuerpo las cabeceras de la petición del cliente, incluyendo la cabecera.


La combinación de este método HTTP con un fallo "Cross Site Scripting" en la aplicación web puede acabar en un robo de sesión de usuario, incluso si las Cookies han sido establecidas como HttpOnly. Este ataque es conocido como "Cross Site Tracing" o XST.


Para más información os recomiendo el siguiente enlace de "el lado del mal":

http://www.elladodelmal.com/2011/11/hijacking-de-cookies-http-only-con-xss.html

PUT

Se intenta subir un fichero:

curl  -T test.txt www.ejemplo.es

Es posible que devuelva un error 417 Expectation Failed.

Entonces se incluye la cabecera Expect:

curl -H Expect: -T test txt www.ejemplo.es

Si se quiere usar Burpsuite, sería:

PUT /test.txt HTTP/1.1
Host: ejemplo.es

 TEST


El uso de este método (así como DELETE) es muy intrusivo por lo que como somos "éticos" no se demuestra su uso mediante PoC, solamente el resultado cuando se encuentra correctamente configurado.

Análogamente, la FOCA identifica la presencia de métodos habilitados en su scan, por lo que se recomienda su uso para no olvidarnos ninguno.

El objetivo de esta entrada es totalmente con fines educativos y formativos, por lo tanto, no nos hacemos responsables de uso para otros fines distintos.

Saludos.

NaxHack5

La mejor defensa es un buen ataque.

viernes, 19 de agosto de 2016

Tr0ll 1 trolleando a Fwhibbit

Buenas hackers! CTF de Vulnhub


Si queréis hacer el CTF, a partir de aquí os recomiendo que no leais nada, simplemente como guía si os veis atascados, como muchas veces me sucede ami cuando resuelvo un CTF, que necesito echarle un ojo jijiji


Atención Spoiler!!


Ejecutamos el netdiscover:

A continuacion usamos nmap, para descubrir las direcciones IP dentro de una subred:


Ahora ya descubierto la direccion IP en la misma red, realizamos un reconocimiento para ver que
puertos tiene abiertos y sus servicios.
Con la opción -sV permite ver la versión de los servicios, con -sS permite TCP SYN, con -A permite la deteción de OS, la versión, script scanning, y traceroute. Con -T4 indica el tiempo de envió de los paquetes, es decir desde 0-6, la más baja es la más lenta, y también mejor ya que podría evadir algunos firewall.


Al ejecutar con -A los scripts por defecto de nmap, como el http-enum.nse, hemos descubierto un archivo llamado robots.txt muy interesante.
Y como se puede apreciar tiene el puerto 21 FTP, con el login anonymous habilitado!!
EL 22 SSH
El 80 HTTP
Ahora con curl, realizamos una petición HTTP con la siguiente dirección del servidor:

Curl: Herramienta muy útil para hacer peticiones HTTP, que nos permite usar distintos protocolos
para dichas peticiones.
Introducimos la dirección del servidor en el navegador y WTF!!!

Usaremos nikto y el CLI de dirb:


También podemos usar wfuzz:


En robots.txt tenemos esto:

Hacemos Curl, y vemos que hay una imagen en la página HTML:


Vamos con el FTP:
Usaremos un auxiliar, para saber la versión aunque ya el Nmap nos lo pudo mostrar anteriormente


Conectamos mediante FTP, y antes de ver el archivo que existe, capturamos trafico para ver lo
vulnerable que es el servicio FTP, dandonos el user y pass en texto claro.


Analizamos a su vez el tráfico capturando paquetes con Wireshark:


Ahora abrimos el archivo lol.pcap:


Y vemos que existe un archivo .txt:


Y leemos su significado, dando a analizar y follow:


También podemos ver el acrhivo lol.pcap con strings:


Probamos el directorio que nos menciona el archivo,en el navegador:


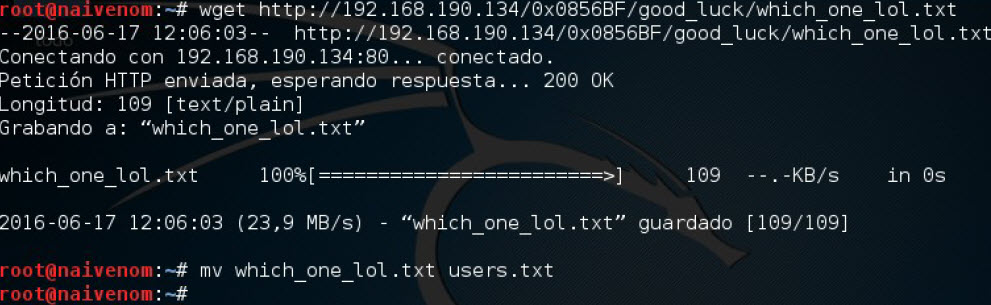
Vemos que existe un binario en el servidor, nos lo descargamos con wget:


Damos permisos de ejecución al binario y ejecutamos:


Bien esta dirección nose en cuanto nos puede ayudar, pero ¿qué podría significar?
Probamos con file para ver el tipo de fichero y strings:


Nos devuelve algo más de información... Siendo una dirección de memoria podríamos usar gdb pero sin resultados positivos. Así que vamos hacer algo más sencillo poniendo esa dirección en el navegador:


Bien pues encontramos dos directorios en la cual podemos encontrar información valiosa, en uno de ellos encontramos un .txt donde contiene usernames, mientras que en el otro directorio tenemos las password.
Por tanto que mejor que descargarnos los archivos con wget y montarnos el diccionario, ya que esto es una vía de acceso en uno de los servicios ya sea ftp o ssh.


Con nano users.txt:


Nos descargamos el archivo pass y creamos el diccionario:


Si visualizas Pass.txt solo viene una linea en el archivo, "buen trabajo", por tanto nose esta maquina tengo la sensación de que me esta troleando jjj, leyendo algún walkthroughs, haré lo siguiente:


Usamos hydra para realizar un ataque de fuerza bruta:


Sin resultados....Probemos con el servicio SSH:


Y si esa era la pass.... :(
Por tanto, vamos a conectarnos por SSH al servidor:


Bien obtuvimos una shell, pero se me cerro la conexion THIS F*** MACHINE IS TROLLING ME?
Si estamos conectados cierto tiempo, nos cierra la conexión...
Bueno nos conectamos de nuevo, y vamos a ver los ficheros con permisos de escritura y redirijimos los errores a /dev/null:


Existe un fichero en Python donde tenemos permisos de escritura, lo visualizamos:


Este script lo que hace es borrar de forma recursiva todo lo contenido en /tmp
En esta carpeta es donde podemos siempre ejecutar algún exploit o scripts para poder realizar una escalada de privilegios.
Seguidamente nos dirijimos a var/log ya que es interesante ver el cron, debido a que quizás haya una tarea programada de ejecutar el script cleaner.py.
Antes veremos los permisos:


Tenemos permisos para escritura, lectura y ejecución con el usuario actual...
Visualizamos:


Efectivamente cada 2 minutos se ejecuta todos los dias este script. Coincide con el tiempo que se nos desconecta la conexión al servidor. Así que si editamos este script y en vez de que borre todo lo que existe en /tmp, copiamos lo que hay en /bin/sh a /tmp/sh y cambiamos a permisos de setuid y ejecutables para cualquier usuario, podremos ser root.


Bien una vez editado el script vamos a esperar a que se nos desconecte, para que el cron haga su trabajo ejecutando el cleaner.py. Nos logueamos y ejecutamos /tmp/sh


Ahora nos dirijimos a /root y alli esta la bandera!:


Espero que os sirva esta posible solución al CTF
Un saludo Naivenom

miércoles, 2 de marzo de 2016

Evil GO.ogle

Buenas hackers!
En esta prueba de concepto os explicare como una persona con fines mal intencionados puede obtener el correo electronico Gmail de los empleados de una organización a través de Twitter como medio de propagación.


A traves del bypass del hsts conocida por @ShargonXL, el link http://www.google.es/?gws_rd=ssl fuerza el http saltandote el https, capturando la cookie de sesión de la cuenta de Gmail si ese usario previamente esta logeado en el navegador. Es un fallo de seguridad ya que un usuario mal intencionado puede enviar ese link a traves de ingenieria social y con un ataque man-in-the-middle obtener la cookie y sesión de Gmail.
¿Se consideraria un fallo de seguridad el degradar de https a http? Si se da el caso o la opinión de que no lo es, ¿por qué se implementa el sistema de seguridad hsts? El hsts precisamente consiste en evitar que una pagina web nunca vaya por http, porque es un protocolo inseguro, entonces ¿por qué el hsts de Google no funciona con ese link?, si la medida de seguridad hsts no funciona un atacante mal intencionando mediante Man-In-The-Middle tiene una capacidad enorme para interceptar las peticiones y respuestas entre un usuario y un servidor de aplicaciones web, es decir, se manda el link,  se abre un esnifer para capturar el trafico, pincha la victima y se obtiene la cookie y el email, saltando el https de Google.

Proof of concept by naivenom,
El empleado con conocimientos de hacking y con sintomas de Burnout (esta quemado con su trabajo :S), realizará un ataque Man-In-The-Middle estando en medio de la comunicación interceptando la información entre el emisor y receptor. Para ello tendrá que estar en la misma red LAN, y utilizar el protocolo IPv4 para el intercambio de datos.
El ataque esta basado en ARP Spoofing, donde el atacante con malas intenciones se colocará entre el router y la victima. Cuando el router envie tráfico a la victima, este pasara primero por la maquina del atacante.
El protocolo ARP permite el conocimiento de la dirección física de otro dispositivo partiendo de la base que conoce una dirección IP.


El planeamiento del ataque deberá ser meticuloso y saber el medio de propagación del link. En este caso el atacante usará el Twitter y mediante ingenieria social convencera al personal de la empresa para seguir esa cuenta. Propagará el link con un mensaje privado a todo el personal diciendo que el lugar del restaurante donde van a cenar es este: http://www.google.es/?gws_rd=ssl

Una vez planeado el ataque, empieza el ataque Man-In-The-Middle:

PASO 1: 

Será necesario que el atacante tenga un portatil y acceso a la red. Cumple de sobra estos requisitos. Abrira el programa EvilFOCA para realizar el ataque Man-In-The-Middle.


Una vez envenenado la tabla ARP de la victima, todos los paquetes enviados entre router y victima pasarán por nosotros.

PASO 2: 

Ahora procedemos a abrir un esnifer de paquetes de red como por ejemplo Wireshark.
Quizas sea este el paso más delicado y dependemos de varios factores:
  • Tiempo que haya de interacción entre victima y el software Twitter
  • Si la victima pincha el enlace o no. Se presupone de nuestra previa habilidad en convencimiento y confianza que le ofrecemos a la victima. 
Una vez que la victima pincha el enlace desde su maquina, se le abrirá la pagina de google y si hay suerte de que tenga ya logeada la cuenta de Gmail, obtendremos la cookie y el correo.


Guardamos la captura en .pcap

PASO 3:

Analizaremos la captura hecha con el software Fiddler.
Podemos observar que a través de la petición GET, obtenemos el Gmail de la victima con tan solo estar logeada.


Con el correo electronico podemos realizar ataques de phishing o envio de malware, obteniendo una shell del sistema victima.

PASO 4: 

Al capturar el tráfico, obtenemos unas cookies. De un modo u otro instalando una extensión en chrome podemos replicar esas cookies y tener la sesión loegada del Gmail victima en nuestra maquina. También deberemos modificar el user-agent con otra extensión proporcionada por Chrome:


Replicamos las cookies que obtenemos en la captura de Wireshark o Fiddler y la añadimos o editamos en nuestro navegador:


Actualizamos con la replica de las cookies obtenidas mediante el esnifer y escribimos la URL del link:


Como pueden observar es fácil a traves de un ataque Man-in-the-middle y el bypass del hsts, obtener información sensible como puede ser el correo electronico o el nombre y apellidos.

P.D Esta prueba de concepto esta realizada con fines educativos siempre en un entorno de trabajo propio, usando la propia red LAN y cuenta de correo (en este caso) de Gmail. No nos hacemos responsables de su mal uso.


Google Analytics